定义
Base64是一种基于64个可打印字符来表示二进制数据的表示方法。
历史
对于电子邮件网络的最初几十年(1971年至1990年代早期),大多数电子邮件消息都是7位US-ASCII字符集中的纯文本。二进制文件(比如图片)不能通过电子邮件进行传输,例如图片中有一个字节为0xff(即255)超过127,那么这个字节就无法通过邮件进行传输了。
为此便设计出Base64这边编码,目的就是为将二进制数据转换为7位的ASCII字符,Base64使用一组6-bit字节数组代替原来8-bit的二进制字节数组,并将该6-bit数组映射到被选定64个可打印的ASCII码之中,这样原先的二进制数组就变成一个ASCII字符串,从而顺利进行传输。
出于相同目的,还诞生了很多类似的编码,比如:uuencoding,Ascii85,SREC,BinHex,kermit等。
编码算法
假设有一组二进制数组(0xff, 0xfe, 0xfd, 0xfc, 0xfb, 0xfa…)
步骤1:将数组中每3个字节分为一组比如 (0xff, 0xfe, 0xfd), (0xfc, 0xfb, 0xfa)…
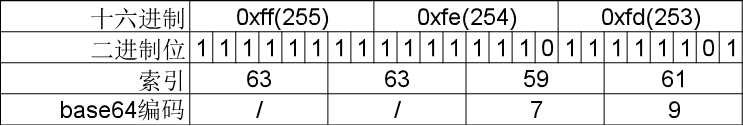
步骤2:将3个字节共24bit平均分为4个6-bit大小的数字,这里以(0xff, 0xfe, 0xfd)为例:
(0xff 0xfe 0xfd)即为(11111111, 11111110, 11111101),进行6-bit分割得(111111|11, 1111|1110, 11|111101),分割后为(111111, 111111, 111011, 111101),用10进制表示(63, 63, 59, 61)
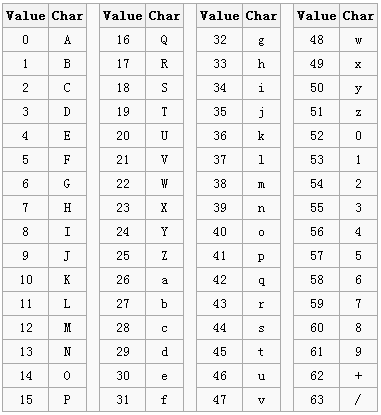
步骤3:将步骤2得到的(63, 63, 59, 61)进行查表替换,标准Base64算法的映射表如下所示,得到(/, /, 7, 9)。
步骤4:根据步骤2、3进行剩余数组的编码。
这里还存在一个问题,假如最后一组被分割数组不足3个字节,这时分为两种情况:
1)剩余2个字节:
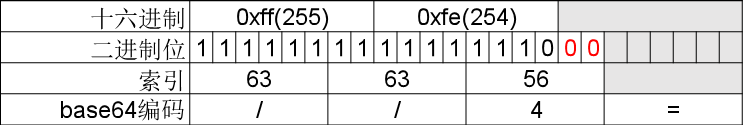
比如(0xff 0xfe)即为(11111111, 11111110),进行6-bit分割得到(111111|11, 1111|1110),这时只能分割为三个部分,且第三部分不足6-bit,需要为其补上2个0,得到(111111, 111111, 111000), 10进制表示(63, 63, 56),根据索引值查表得到(/, /, 4 ),因为只有三个字符,所以还需要为其补充一填充字符=,最后编码为(/, /, 4, =)。
2)剩余1个字节:
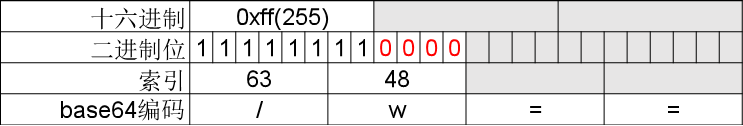
比如(0xff)即为(11111111,),进行6-bit分割得到(111111|11),这时只能分割为两个部分,且第二部分不足6-bit,需要为其补上4个0,得到(111111, 110000), 10进制表示(63, 48),根据索引值查表得到(/, w),因为只有两个字符,所以还需要为其补充两个填充字符=,最后编码为(/, w, =, =)。
标准Base64映射表
Base64变种
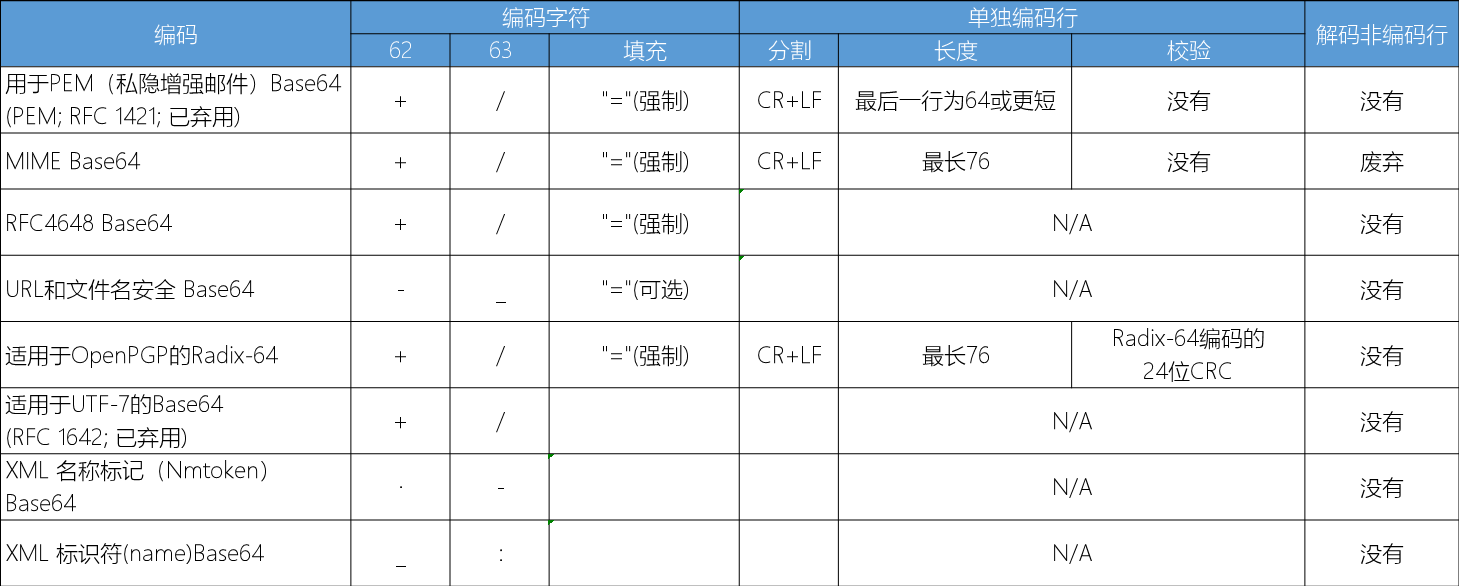
Base64其实不单单只有一种,为适应更多场景使用,它产生了很多变种,其中第0到第61个映射字符是一样的,不同主要集中在第62、63字符,没有填充字符,是否需要换行以及行长度限制。下面是Base64变种部分汇总表:
说明:
1)目前网上在线Base64编解码绝大多数采用的是RFC4648 Base64,它的特点是第62、63映射字符为’+’, ‘/’,没有行长度限制,不会加入回车换行符。
2)有些编程语言采用MIME Base64方式,这样当编码字符串长度大于76时,就会加上回车换行符,从而该编码字符串被应用到其它地方可能会引发些问题。
3)当URL参数使用Base64进行编码,这时映射字符’+’,’/’, 填充字符’=’,会被转换成”%XX”形式,而这些’%’在存入数据库前还需要进行转换,因为ANSI SQL中已将’%’字符作为通配符。这时可以选择使用Base64url,这种Base64将’+’ , ‘/’使用’-‘, ‘_’ 替代,并且不再强制使用填充字符”=”。
4)在XML中应用Base64可以使用”XML 名称标记(Nmtoken) Base64 “和”XML 标识符(name) Base64”。
常用编程语言
1)python3 base64模块
#导入base64模块
import base64
original = b'python3 base64 demo'
#编码
encoded = base64.b64encode(original)
print(encoded)
#解码
decoded = base64.b64decode(encoded)
print(decoded)
注意:在Python3中,Base64编码仅仅用于面向字节的数据比如字节字符串和字节数组。 此外,编码处理的输出结果总是一个字节字符串。当解码Base64的时候,字节字符串和Unicode文本都可以作为参数。 但是,Unicode字符串只能包含ASCII字符。
如果你想混合使用Base64编码的数据和Unicode文本,你必须添加一个额外的解码步骤。
encoded = base64.b64encode(original).decode('ascii')
2)javascript base64
 //编码
function b64EncodeUnicode(str) {
    return btoa(encodeURIComponent(str).replace(/%([0-9A-F]{2})/g, function(match, p1) {
        return String.fromCharCode('0x' + p1);
    }));

b64EncodeUnicode('✓ à la mode'); // "4pyTIMOgIGxhIG1vZGU="


//解码
function b64DecodeUnicode(str) {
    return decodeURIComponent(atob(str).split('').map(function(c) {
        return '%' + ('00' + c.charCodeAt(0).toString(16)).slice(-2);
    }).join(''));
}

b64DecodeUnicode('4pyTIMOgIGxhIG1vZGU='); // "✓ à la mode"
b64DecodeUnicode('Cg=='); // "\n"
说明:函数btoa和atob是javascript原生base64编解码接口,由于 DOMString 是16位编码的字符串,所以如果有字符超出了8位ASCII编码的字符范围时,在大多数的浏览器中对Unicode字符串调用 window.btoa 将会造成一个 Character Out Of Range 的异常。所以需要使用encodeURIComponent/decodeURIComponent进行处理。
3)objective-c base64
//编码
- (NSString*)base64Encode:(NSString*)string
{
    NSData* data = [string dataUsingEncoding:NSUTF8StringEncoding];
    // option选项:
    // 默认为0,不换行,结尾为回车换行符
    // NSDataBase64Encoding64CharacterLineLength 编码行长度限制为64
    // NSDataBase64Encoding76CharacterLineLength 编码行长度限制为76
    // NSDataBase64EncodingEndLineWithCarriageReturn 结尾为回车符
    // NSDataBase64EncodingEndLineWithLineFeed    结尾为换行符
    return [data base64EncodedStringWithOptions:0];
}

//解码
- (NSString*)base64Decode:(NSString*)string
{
    NSData* data = [[NSData alloc]initWithBase64EncodedString:string options:0];
    return [[NSString alloc]initWithData:data encoding:NSUTF8StringEncoding];
}
Base系列编码
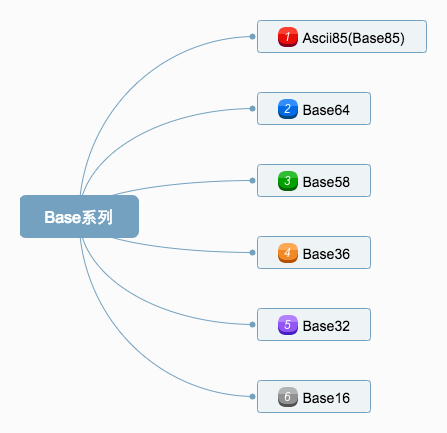
Base64是Base系列编码其中一种,Base系列中还有ascii85(Base85)、Base58、Base36、Base32、Base16。
1.Ascii85(Base85)
Ascii85,也称为Base85,是由Paul E. Rutter为btoa实用程序开发的二进制文本编码形式。通过使用五个ASCII字符来表示四个字节的二进制数据(使编码大小¹/ 4大于原始值,假设每个ASCII字符为8位),它比uuencode或Base64更有效,它使用四个字符来表示三个字节数据的增加(¹/ 3增加,假设每个ASCII字符有8位)。
它的主要现代用途是Adobe的PostScript和可移植文档格式文件格式,以及Git使用的二进制文件的补丁编码。
2.Base58
Base58是一组二进制到文本编码方案,用于将大整数表示为字母数字文本,由Satoshi Nakamoto介绍用于比特币。它已被应用于其他加密货币和应用程序。
它类似于Base64,但已经过修改,以避免使用非字母数字字符和字母,这些字符在打印时可能看起来不明确。因此,它专为手动输入数据,从某些可视源复制的人类用户而设计,但也允许轻松复制和粘贴,因为双击通常会选择整个字符串。
与Base64相比,省略了以下相似的字母:0(零),O(大写o),I(大写i)和l(小写L)以及非字母数字字符+(加号)和/ (削减)。与Base64相比,编码的数字与原始数据的字节边界不能很好地对齐。出于这个原因,该方法非常适合编码大整数,但不能用于编码二进制数据的较长部分。字母表中字母的实际顺序取决于应用程序,这就是单独使用术语“Base58”不足以完全描述格式的原因。与Base 58相比,变体Base56排除1 和o(小写o)。
3.Base36
base36编码,它的编码中包含0~9的数字,加上所有26个字母,不区分大小写,不包含任何标点,所有的字母要不全大写,要不全小写。所以加起来就是“0123456789ABCDEFGHIJKLMNOPQRSTUVWXYZ”, 或者 ‘0123456789abcdefghijklmnopqrstuvwxyz’。
4.Base32
Base32编码是使用32个可打印字符(字母A-Z和数字2-7)对任意字节数据进行编码的方案,编码后的字符串不用区分大小写并排除了容易混淆的字符,可以方便地由人类使用并由计算机处理。
与Base64相比,Base32具有许多优点:
- 适合不区分大小写的文件系统,更利于人类口语交流或记忆。
- 结果可以用作文件名,因为它不包含路径分隔符 “/”等符号。
- 排除了视觉上容易混淆的字符,因此可以准确的人工录入。(例如,RFC4648符号集忽略了数字“1”、“8”和“0”,因为它们可能与字母“I”,“B”和“O”混淆)。
- 排除填充符号“=”的结果可以包含在URL中,而不编码任何字符。
Base32的缺点:
- Base32比Base64多占用大约20%的空间。因为Base32使用8个ASCII字符去编码原数据中的5个字节数据,而Base64是使用4个ASCII字符去编码原数据中的3个字节数据。
5.Base16
Base16编码使用16个ASCII可打印字符(数字0-9和字母A-F)对任意字节数据进行编码。Base16先获取输入字符串每个字节的二进制值(不足8比特在高位补0),然后将其串联进来,再按照4比特一组进行切分,将每组二进制数分别转换成十进制,在下述表格中找到对应的编码串接起来就是Base16编码。可以看到8比特数据按照4比特切分刚好是两组,所以Base16不可能用到填充符号“=”。
Base16编码后的数据量是原数据的两倍:1000比特数据需要250个字符(即 250*8=2000 比特)。换句话说:Base16使用两个ASCII字符去编码原数据中的一个字节数据。
Base16编码是一个标准的十六进制字符串(注意是字符串而不是数值),更易被人类和计算机使用,因为它并不包含任何控制字符,以及Base64和Base32中的“=”符号。